2025 · 综述论文 · 机器遗忘
A Survey of LoRA-based Machine Unlearning for LLMs: Methods, Taxonomy, and Evaluation
一篇以适配器为中心的综述,讨论 LoRA 模块如何执行遗忘、维持效用,并支撑面向大语言模型的可审计删除流程。
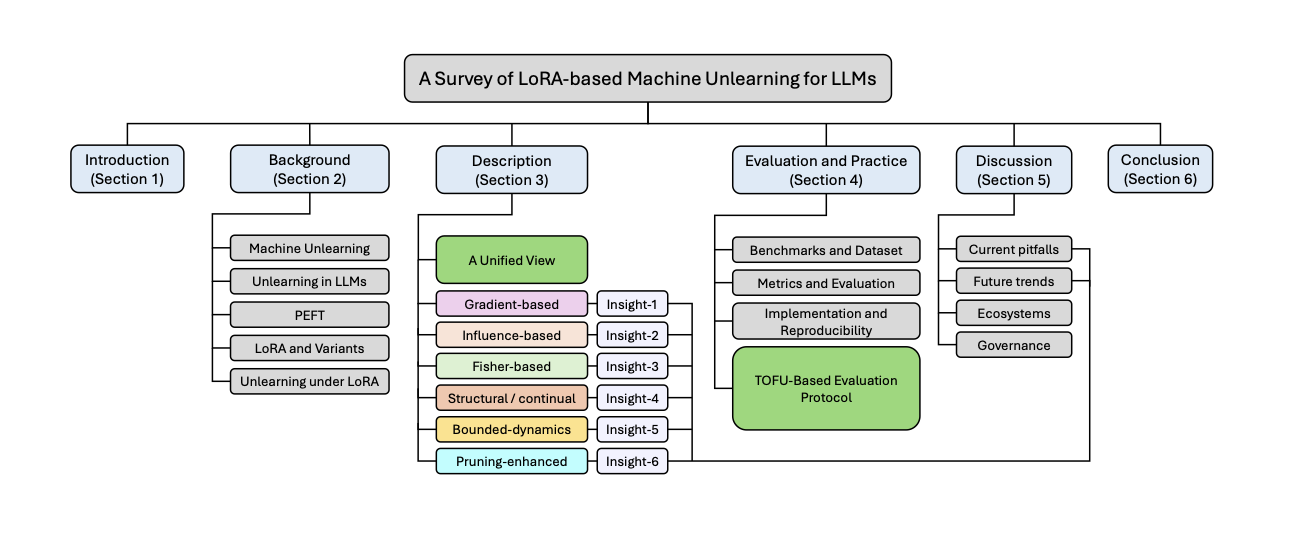
概览
这篇论文的核心贡献
面向适配器的遗忘问题表述
论文在冻结主干模型和显式 retain/forget 划分下形式化 LoRA 机器遗忘,使适配器检查点成为删除操作的主要承载体。
统一的算子化视角
作者把现有方法拆成分数构造、预条件、投影、约束与掩码几个环节,使跨家族比较更加清楚。
六类方法谱系
现有工作被组织为梯度式、影响函数式、Fisher 信息式、结构式、有界动力学式与剪枝或稀疏式方法。
评测与部署建议
论文汇总 TOFU 风格报告方式、效用与隐私权衡、持续删除行为以及治理落地中的工程问题。
摘要
为什么 LoRA 机器遗忘值得单独做一篇综述
随着大语言模型走向真实部署,机器遗忘正在从学术议题变成工程需求。但许多既有方法默认可以访问全模型并承担重训成本,这在真实系统中往往并不现实。
与此同时,现代适配流程越来越依赖参数高效微调,尤其是把 LoRA 模块附着在冻结主干上,并作为轻量检查点分发的做法。
这篇综述聚焦适配器空间中的遗忘:删除请求如何主要在 LoRA 空间内完成,不同方法家族如何权衡遗忘与保留能力,以及这些选择对隐私泄露、持续更新和运维治理意味着什么。